Toda semana aparece uma fuleiragem nova nessa nossa bolha tech. Junto a ela, geralmente, aparece um monte de termos novos que muitas vezes só servem para “gourmetizar” um processo que já é feito e às vezes já tem até nome.
Eu levantei aqui uns termos pra quem tá entrando no mundo de IA, que se escuta o tempo todo, mas tem uma galera que não sabe nem do que se trata. Ou acha que é um bagulho de tecnologia de lançar foguete.
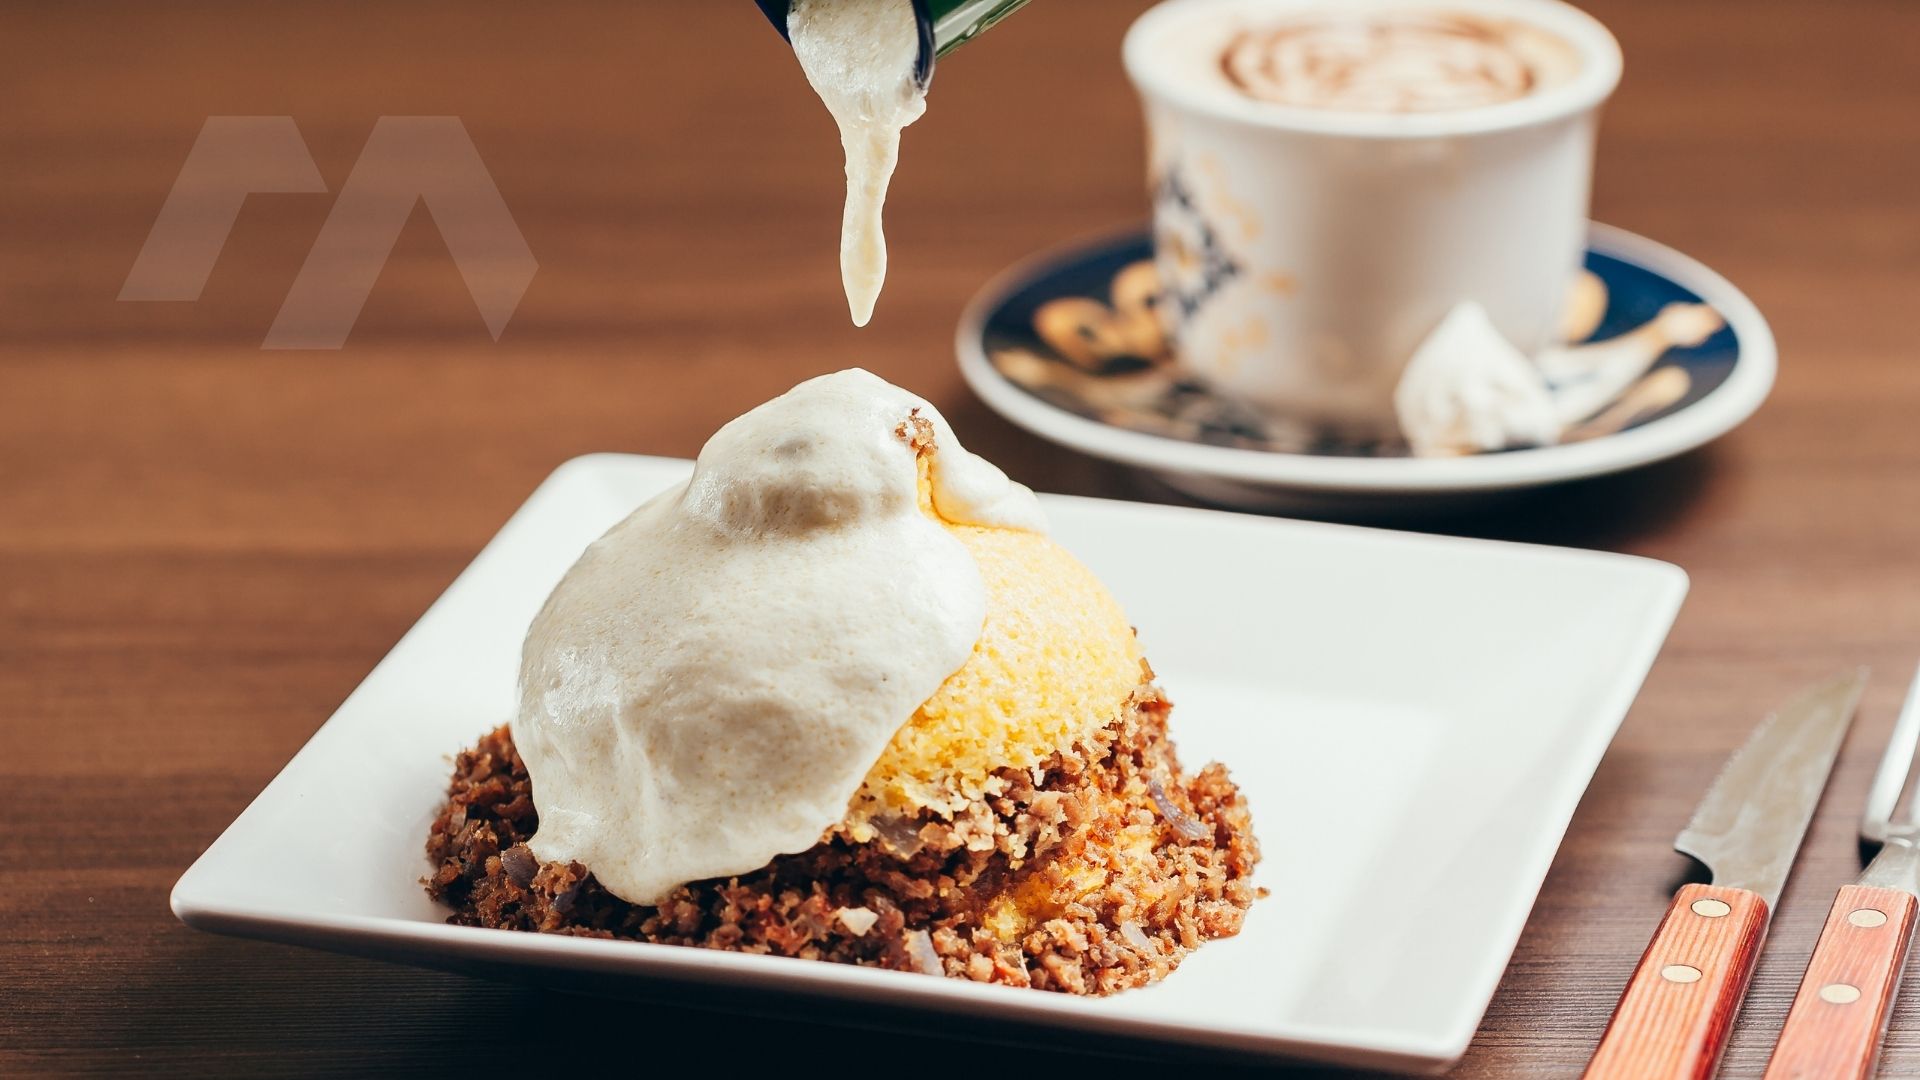
Então lê aí e aprende que flocos de Zea mays domesticado (milho), dispostos em um cilindro perfeito e aerado, de coloração ouro-nativo, que desmancha delicadamente ao toque do garfo, revelando camadas harmoniosas de recheios nobres… É SÓ CUSCUZ.
Começando pelo LLM, que é o tal do Large Language Model. É o modelo que recebe um contexto e gera uma resposta baseado nos padrões que aprendeu. Quando você conversa com uma IA e fica impressionado porque ela entendeu sua pergunta, escreveu um código ou explicou um negócio complicado, boa parte da mágica que você está vendo vem daí. Não tem um pequeno estagiário dentro do servidor pesquisando a resposta no Google. O modelo aprendeu uma quantidade absurda de padrões e usa isso para gerar a resposta.
Mas ele precisou aprender isso em algum momento, né? Aí entra o treinamento. É quando o modelo é exposto a uma quantidade gigantesca de dados e vai aprendendo padrões de linguagem, relações entre conceitos e por aí vai. Simplificando bastante: é a fase em que ele aprende. Depois ainda existem outras etapas para especializar e ajustar o comportamento do modelo, mas não vou gourmetizar o treinamento no post que reclama de gourmetização.
Aí você pergunta: “Beleza, mas e quando eu preciso que a IA saiba alguma coisa que não estava nesses dados ou que aconteceu depois?”. É aqui que aparece o RAG. Em vez de esperar que o modelo tire a informação da cabeça, a aplicação busca conteúdo em algum lugar (documentos, banco de dados, base de conhecimento, repositório etc.) e entrega aquilo como contexto para ele responder. É quase um “não precisa saber de cabeça, consulta aqui e depois me responde”. Claro que a qualidade da resposta ainda depende do que foi encontrado e do que foi colocado no contexto. RAG não transforma informação ruim em verdade só porque ganhou uma sigla bonita.
Até aqui a IA está basicamente respondendo coisas. Só que uma hora alguém olhou pra isso e pensou: “massa, mas e se ela pudesse fazer as coisas também?”. Entram os agentes. Além de gerar uma resposta, a aplicação pode dar acesso a ferramentas para consultar uma API, pesquisar alguma coisa, ler ou alterar arquivos, executar código, atualizar um sistema e por aí vai. Dependendo de como o agente foi construído, ele consegue analisar o que precisa fazer, escolher ferramentas, executar ações, observar o resultado e continuar até chegar ao objetivo. Basicamente saiu do “me diga como fazer” para o “vá lá e faça”.
E aí chegamos no MCP, outra sigla que começou a aparecer em todo canto. O Model Context Protocol é uma forma padronizada de conectar aplicações de IA a ferramentas e fontes de contexto. Imagina que cada serviço tem um jeito diferente de disponibilizar arquivos, dados ou ferramentas para uma aplicação de IA. Em vez de criar uma gambiarra diferente pra cada integração, o MCP propõe uma interface comum pra essa conversa acontecer. Não é obrigatório para criar agente, não é o negócio que “faz a IA pensar” e também não é magia. É protocolo. Só que protocolo parece menos emocionante no LinkedIn.
Por último tem o System Prompt. Sabe quando você abre uma aplicação de IA e ela já “sabe” que deve responder de determinada maneira, seguir certas regras ou assumir determinado papel, mesmo você não tendo explicado nada disso? Provavelmente existem instruções definidas pela aplicação antes mesmo da sua mensagem chegar ao modelo. É mais ou menos o manual de “como você deve se comportar aqui”. Ele ajuda a definir papel, regras, contexto, formato das respostas e limites. E não, escrever “JAMAIS FAÇA ISSO” em caixa alta no System Prompt não transforma sozinho sua aplicação numa fortaleza de segurança.
Quando junta tudo, aquele chat bonitinho que parece simplesmente receber uma pergunta e devolver uma resposta começa a mostrar a quantidade de coisa que pode estar acontecendo por baixo dos panos.
O modelo foi treinado, o LLM processa o contexto e gera a resposta, o RAG pode trazer informação de fora, um agente pode decidir usar ferramentas, o MCP pode padronizar a comunicação com essas ferramentas e o System Prompt ajuda a definir as regras do jogo.
Parece complicado quando jogam todas essas siglas numa apresentação.
Separando as coisas, é só cuscuz.